Technologies d'IA pour l'automatisation des SOC
Au début des années 2000, nous avons commencé à utiliser des algorithmes de machine learning pour détecter les logiciels malveillants. Depuis, les pirates informatiques ont perfectionné leurs méthodes. Les attaques ciblées actuelles se caractérisent par un haut degré de discrétion : elles recourent notamment très peu à des programmes malveillants détectables par les antivirus. De nombreux pirates informatiques privilégient plutôt l'ingénierie sociale pour obtenir un accès initial, puis exploitent les erreurs de configuration des systèmes et des logiciels légitimes pour se déplacer latéralement et s'implanter durablement dans les infrastructures compromises.
La détection de ce type d'attaque nécessite de collecter et d'analyser une grande quantité de données sur le comportement des appareils, des applications et des utilisateurs au sein du réseau d'entreprise. Chaque fois qu'une activité suspecte est détectée, il convient alors de déterminer s'il s'agit d'une attaque ou d'une activité légitime. À mesure que le nombre de ressources d'une organisation augmente, le volume des données télémétriques collectées s'accroît également, ce qui alourdit la charge de travail des analystes travaillant au sein des Centres de supervision de la sécurité et des services MDR.
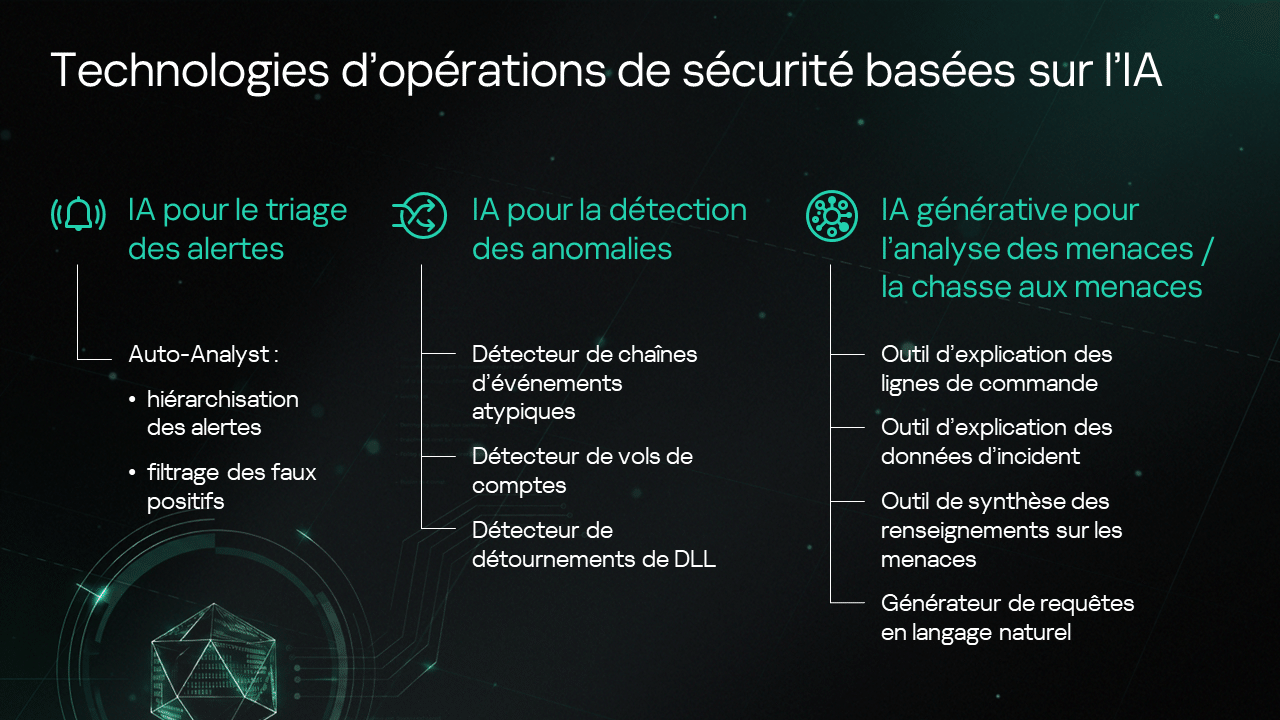
L'automatisation fondée sur les technologies d'IA permet de simplifier considérablement ce travail dans plusieurs domaines :
- Triage : hiérarchisation des alertes relatives aux événements suspects dans les données télémétriques MDR/XDR/SIEM et filtrage des faux positifs.
- Détection des anomalies comportementales : identification des signes de vol de comptes, de compromission d'hôtes, d'attaques par piratage DLL et d'autres activités malveillantes.
- Présentation des données : synthèse et interprétation des lignes de commande, des incidents et des rapports de TI.
- Recherche des menaces en langage naturel : traduction des hypothèses des analystes en requêtes SQL.
Ci-dessous, nous décrivons comment ces technologies d'IA sont mises en œuvre concrètement dans nos produits et services.
Analyse automatique et hiérarchisation des alertes
Les infrastructures des clients de notre service MDR génèrent chaque jour des milliards d'événements de sécurité. Le système de collecte de données identifie les événements suspects à l'aide de règles de détection spécifiques et signale ces activités potentiellement malveillantes aux analystes sous forme d'alertes, ce qui représente plusieurs centaines de milliers de messages par an. Toutefois, seul un dixième environ de ces alertes concerne de véritables incidents de sécurité.
Les analystes doivent donc filtrer les « fausses alertes », qui constituent la majeure partie des alertes. Pour ce faire, nous avons développé un système d'IA appelé Auto-Analyst. Ce système de machine learning supervisé est entraîné à partir d'alertes accompagnées des verdicts des analystes du SOC. L'objectif est d'identifier avec certitude les faux positifs générés par des activités réseau légitimes.
Le machine learning repose ici sur CatBoost, une bibliothèque de gradient boosting largement utilisée. Le système entraîné Auto-Analyst filtre les alertes et ne transmet pour examen humain que celles qui présentent un risque d'incident réel supérieur à un seuil défini, ce seuil étant déterminé selon un taux d'erreur acceptable. Ainsi, environ 30 % des alertes sont traitées uniquement par l'IA, ce qui laisse plus de temps à l'équipe du SOC pour se consacrer à des tâches plus complexes. Les alertes transmises pour analyse humaine sont classées par ordre de priorité, ce qui permet aux analystes de se concentrer en premier lieu sur les alertes les plus critiques.
Vous trouverez davantage de détails sur les subtilités pratiques du fonctionnement d'Auto-Analyst (contrôle des données d'entraînement, examen sélectif des résultats, etc.) dans un article distinct rédigé par nos experts.
Détection des anomalies dans les systèmes SIEM
Cette approche consiste essentiellement à utiliser les données télémétriques obtenues pendant le fonctionnement « normal » du système pour entraîner un modèle d'IA qui signalera ensuite tout écart par rapport au comportement habituel.
L'utilisation de tels algorithmes dans de grands systèmes distribués est compliquée par le très grand nombre de paramètres à prendre en compte lors de la création du modèle. De plus, ces modèles peuvent générer un grand nombre de faux positifs : dans une organisation comptant des milliers d'utilisateurs, de nombreux cas de comportements atypiques peuvent être légitimes.
Toutefois, cette approche peut s'avérer très efficace pour des ressources et des processus spécifiques, pour lesquels il est possible d'élaborer un modèle suffisamment précis du fonctionnement normal.
Chaînes d'événements anormales
Dans ce cas, les données relatives aux séquences typiques de déclenchement des règles de corrélation SIEM sont utilisées pour établir un modèle de comportement normal. Les déclenchements fréquents d'une même séquence correspondent généralement à de faux positifs (par exemple, l'exécution automatisée de scripts administratifs) et peuvent servir d'indicateur d'une activité typique au sein de l'infrastructure.
En établissant un profil du comportement typique d'un hôte sous la forme d'un ensemble de probabilités de déclenchement de certaines règles, notre système d'IA peut évaluer dans quelle mesure chaque nouvelle chaîne d'événements est typique ou atypique pour l'infrastructure concernée. La détection d'une chaîne atypique conduit le système à augmenter la priorité de l'alerte, afin d'attirer l'attention des spécialistes de la sécurité pour une analyse plus approfondie.
Vol de comptes
Une autre technologie de détection des anomalies permet de détecter les activités potentiellement non autorisées des comptes utilisateurs. Ici, le système de ML utilise des paires d'entités comme`account-IP`, `account-host`, `account-country`, etc. pour créer des profils de comportement typiques des comptes.
Un pirate informatique utilisant un compte volé perturbe généralement le schéma d'activité habituel. Les pirates informatiques se connectent au système à partir d'adresses inhabituelles, puis cherchent des moyens de se déplacer latéralement ou d'élever leurs privilèges au sein du système, en accédant à des nœuds de l'infrastructure que l'utilisateur légitime du compte n'aurait jamais consultés. Le système d'IA détecte ces anomalies et rassemble les informations contextuelles nécessaires dans une alerte, permettant ainsi aux analystes de réagir rapidement à ces incidents.
Piratage DLL
Le piratage DLL est une technique d'attaque sous Windows dans laquelle les pirates informatiques remplacent une bibliothèque appelée par un processus légitime par une bibliothèque malveillante. La détection de ce type d'attaque à l'aide des solutions de sécurité classiques n'est pas simple, car la bibliothèque malveillante s'exécute au sein de l'espace d'adressage de confiance d'un processus légitime. Cette activité peut donc être considérée par une solution de sécurité comme provenant d'un processus de confiance. Il n'est donc pas surprenant que le nombre d'attaques recourant au piratage DLL ait considérablement augmenté ces dernières années.
Pour créer un modèle d'IA capable de distinguer les chargements de bibliothèques malveillants de ceux qui sont légitimes, nos experts ont identifié un certain nombre de caractéristiques présentes dans les cas suspects : emplacement erroné de la bibliothèque, emplacement erroné du fichier exécutable, fichier exécutable renommé, modifications de la taille et de la structure de la bibliothèque, absence de signature, etc. Pour l'échantillon d'entraînement, nous avons utilisé des données de chargement DLL fournies par nos systèmes internes de traitement automatique, ainsi que des données télémétriques d'utilisateurs anonymisées provenant de KSN.
Vous trouverez plus de détails sur le processus d'entraînement de ce modèle dans un rapport distinct. Même au stade pilote, cette technologie a permis d'éviter plusieurs attaques dans les systèmes de nos clients.
Assistants d'IA basés sur des modèles génératifs
Tous les exemples précédents concernent l'utilisation de l'IA comme classificateur : lorsqu'il reçoit un nouvel objet d'information, le modèle le classe dans une certaine catégorie (« C'est un chien. »). Ces systèmes de ML sont généralement entraînés à partir d'un échantillon limité de données directement applicables à la tâche.
L'IA générative fonctionne « à l'envers ». Le système reçoit une requête correspondant à un certain type de résultat souhaité (« Dessine-moi un chien. ») et produit de nouveaux objets d'information répondant au type souhaité. Pour ce faire, le système utilise des « connaissances » approfondies dans le domaine concerné, acquises grâce à l'entraînement préalable d'un grand modèle de langage (LLM) sur d'immenses ensembles de données publiques.
Cela permet d'utiliser des systèmes basés sur des LLM pour un large éventail de tâches, notamment le traitement de données non structurées. Les LLM actuels sont particulièrement performants pour les tâches de traitement de texte, comme la traduction, l'interprétation et la synthèse (c'est-à-dire la création d'une version abrégée du texte d'origine tout en conservant les idées principales).
Pour accomplir des tâches similaires de traitement de texte dans les produits et services de sécurité, nous avons développé notre propre technologie d'assistant IA. Cette technologie prépare les données destinées aux requêtes adressées aux LLM, formule et envoie ces requêtes, traite les résultats et les transmet aux analystes, tout en garantissant la sécurité de l'ensemble des communications.
L'assistant d'IA peut fonctionner avec n'importe quel LLM choisi par le client en fonction de ses tâches et de ses exigences. Par exemple, les modèles cloud sont généralement plus puissants que ceux déployés localement, mais l'utilisation de modèles déployés localement évite de transmettre des données confidentielles à des services tiers.
Interprétation des lignes de commande
Une ligne de commande brouillée est un type courant d'événement suspect qui nécessite un examen approfondi de la part d'un analyste. Les pirates informatiques utilisent ce type de ligne pour transmettre leurs instructions directement au système d'exploitation de l'hôte attaqué tout en évitant d'être détectés. Pour camoufler les commandes malveillantes, ils recourent au codage, à la manipulation syntaxique et à de nombreuses autres méthodes de brouillage, ce qui rend difficile l'identification des véritables intentions de l'auteur de la commande.
Notre assistant IA procède d'abord à un désembrouillage statique de la ligne suspecte. Il envoie ensuite une série de requêtes au LLM pour obtenir des explications sur tous les paramètres de la ligne de commande. Enfin, l'assistant présente à l'analyste une synthèse décrivant ce que fait cette ligne et son niveau de dangerosité.
Synthèse des données relatives aux incidents
Pour automatiser la réponse aux incidents, les SOC actuels utilisent les fonctionnalités d'une plateforme de réponse aux incidents (IRP). Ce programme regroupe dans une seule fiche toutes les données relatives à un incident, y compris les événements de sécurité et les artefacts associés.
Cependant, ce regroupement de données peut être très volumineux, et l'analyse manuelle de tous les détails d'un incident prend du temps. Par ailleurs, les analystes doivent parfois se remémorer d'anciens incidents, ce qui nécessite de réunir les pièces d'anciens puzzles.
L'assistant d'IA générative simplifie considérablement ce travail. Il collecte toutes les données télémétriques relatives à l'incident et, à l'aide d'un LLM, produit une brève explication de ce qui s'est passé, en incluant notamment le vecteur d'attaque initial et les actions menées par le pirate informatique tout au long de l'incident, ainsi que des recommandations sur la réponse à apporter.
Synthèse de Threat Intelligence (TI)
Lorsqu'ils enquêtent sur un incident, les analystes consultent souvent des sources d'informations complémentaires sur la menace en question. L'une de ces sources est notre Threat Intelligence Portal (TIP), qui contient plus de cinq pétaoctets de TI collectés par Kaspersky au cours de plus d'un quart de siècle de travail sur la détection des menaces : hachages de fichiers malveillants, caractéristiques statistiques et comportementales, adresses IP et URL des centres de commande et de contrôle, TTP des groupes de pirates informatiques, etc.
Voici à quoi ressemble un scénario typique d'utilisation du portail : un analyste charge un échantillon suspect découvert lors d'une enquête sur un incident et l'exécute dans le sandbox du portail. Il obtient alors des analyses détaillées, notamment les verdicts et les hachages des programmes malveillants détectés, les adresses de domaines avec lesquels ils ont établi une connexion, les fichiers téléchargés depuis Internet, etc.
Toutes ces données peuvent servir de paramètres pour rechercher une TI supplémentaire à partir de sources ouvertes. Par exemple, le portail peut afficher des rapports sur un groupe APT qui utilise les mêmes adresses C2 que celles détectées lors de l'exécution de l'échantillon dans le sandbox. L'analyste dispose ainsi d'IoC supplémentaires à rechercher au sein de son infrastructure.
Cependant, l'étude de rapports de TI disparates peut prendre beaucoup de temps, surtout s'ils sont rédigés dans des langues et des formats différents. Notre assistant IA crée une synthèse structurée de ces rapports qui montre comment un indicateur donné est lié à un groupe particulier, où et quand ce groupe était actif, quelles techniques il utilise, etc. De même, l'assistant IA peut créer une description structurée d'un groupe APT donné à partir de données OSINT.
Recherche des menaces en langage naturel
Lorsqu'un analyste souhaite obtenir des données supplémentaires sur l'incident en cours ou identifier de manière proactive une menace à partir d'indicateurs récemment reçus, il doit formuler une requête à destination d'un système de stockage de journaux ou d'une base de données SIEM/EDR/XDR, où les événements de sécurité sont collectés. Cependant, la traduction des hypothèses de l'analyste en requêtes SQL avec une syntaxe précise et des paramètres corrects peut prendre beaucoup de temps et ralentir les processus d'enquête et de réponse.
Notre assistant IA permet aux analystes de formuler des requêtes à destination de la base de données en langage naturel, c'est-à-dire littéralement au niveau de l'hypothèse. L'analyste peut par exemple dire : « Affiche tous les événements survenus hier sur tels ou tels hôtes et impliquant un fichier exécutable portant tel ou tel nom. » À la réception de cette demande, l'assistant IA utilise un LLM pour sélectionner les champs nécessaires dans le modèle de données, puis envoie une requête SQL à la base de données. Avant l'exécution effective, les analystes peuvent examiner la requête générée par IA, valider sa logique et ajuster les paramètres ou la syntaxe s'ils le souhaitent.


