Le web profond (Deep Web) peut sembler mystérieux, mais vous l'avez probablement utilisé plusieurs fois aujourd'hui sans vous en rendre compte. Une grande partie se compose de services et d'informations en ligne ordinaires qui n'apparaissent pas dans les résultats des moteurs de recherche.
Contrairement au web clandestin (Dark Web), le web profond ne requiert pas de logiciels spécialisés ni d'outils d'anonymisation. Voici ce qu'il comprend, comment il fonctionne et pourquoi la distinction importe.
Qu'est-ce que le web profond?
Le web profond regroupe tout contenu web que les moteurs de recherche standards n'indexent pas, comme votre boîte mail ou l'historique de vos commandes en ligne. Ce n'est pas un réseau ni une technologie distincte, et la plupart des gens l'utilisent au quotidien.
Votre boîte de réception compte parmi les contenus du web profond parce que les moteurs de recherche ne peuvent pas y accéder. La définition du web profond porte sur la visibilité et l'accès via les moteurs de recherche, et n'a rien à voir avec le caractère suspect ou illégal d'une page.
- La plupart des personnes utilisent le web profond chaque jour sans logiciel spécial ni connaissances techniques spécifiques.
- La consultation du web profond est légale, mais la loi s'applique toujours aux actions que vous y entreprenez.
- Le web clandestin est une petite partie volontairement cachée du web profond qui nécessite généralement Tor.
- Qu'une page soit introuvable par les moteurs de recherche n'implique pas qu'elle soit sûre: un contenu privé nécessite toujours un mot de passe.
- Le phishing et la réutilisation des mots de passe sont des méthodes courantes employées par les attaquants pour compromettre des comptes du web profond.
Web de surface vs. web profond
Les moteurs de recherche utilisent des robots d'exploration pour découvrir des pages web et décider lesquelles intégrer à leurs index. Le web de surface regroupe le contenu public indexé par ces moteurs, tandis que le web profond correspond au contenu non indexé.
Un même site peut contenir les deux. Par exemple, les pages produit d'une boutique en ligne peuvent apparaître dans les résultats, alors que votre historique de commandes n'est accessible qu'après connexion.
Comment fonctionne le web profond?
Le web profond existe parce que des barrières empêchent les robots d'exploration de trouver ou de lire une page. Il peut s'agir d'un écran de connexion, d'un paywall ou d'une directive du propriétaire du site demandant d'ignorer la page.
Les sites utilisent ces mécanismes sans technologie spéciale, et certaines pages cumulent plusieurs barrières. Voici les raisons les plus courantes pour lesquelles un robot manque une page:
|
Barrière |
Exemple |
Pourquoi les moteurs manquent la page |
|---|---|---|
|
Connexions et contrôles d'accès |
Votre compte e‑mail ou un système interne d'entreprise |
Un robot n'a pas de nom d'utilisateur ni de mot de passe, il s'arrête donc à la page de connexion. |
|
Paywalls et abonnements |
Sites d'actualité et services de streaming |
Le contenu complet peut nécessiter un abonnement, bien que les moteurs de recherche puissent parfois indexer des pages payantes ou des extraits. |
|
Contenu généré dynamiquement (par la base de données) |
Résultats de recherche de vols |
Certains résultats ne sont générés qu'après qu'un utilisateur a soumis une requête, ce qui les rend difficiles à découvrir et indexer pour les moteurs standards. |
|
Pages non liées |
Un document partagé par lien direct |
Les robots trouvent les pages en suivant des liens, et aucune autre page ne renvoie vers celle-ci. |
|
Restrictions pour les robots |
Pages qu'un propriétaire demande aux moteurs d'ignorer |
Un fichier robots.txt peut limiter l'accès des robots, tandis qu'une directive noindex indique aux moteurs de ne pas inclure une page dans leurs résultats. Aucune de ces mesures ne protège les informations privées: ce sont des demandes que les moteurs respectent généralement, mais qu'un site ne peut pas appliquer de force. |
Un robot d'exploration bute sur ces barrières, mais les personnes disposant du bon identifiant, du lien ou des permissions peuvent y accéder. De même, quiconque trouve l'adresse d'une page non liée peut y parvenir, et les restrictions pour robots ne sont que des requêtes qu'un site ne peut pas faire respecter. Pour protéger le contenu privé, les sites comptent sur des mots de passe et des permissions, et ceux qui traitent des données sensibles ajoutent généralement une chiffrement, afin que toute interception en transit soit plus difficile à lire.
Testé de manière indépendante et primé par les laboratoires de référence du secteur.



Quelle est la différence entre le web profond et le web clandestin?
Le contenu du web profond reste hors des résultats pour diverses raisons, notamment des exigences de connexion, des restrictions d'accès et des limites techniques. Le web clandestin est une portion beaucoup plus réduite et intentionnellement cachée du web profond qui utilise des réseaux d'anonymisation pour dissimuler l'identité des utilisateurs et des opérateurs de sites.
Les services du web clandestin utilisent souvent des adresses en.onion et requièrent des logiciels spécialisés comme le Tor Browser pour y accéder. Ces services peuvent répondre à des besoins légitimes de confidentialité mais sont aussi susceptibles d'être utilisés pour des activités illégales.
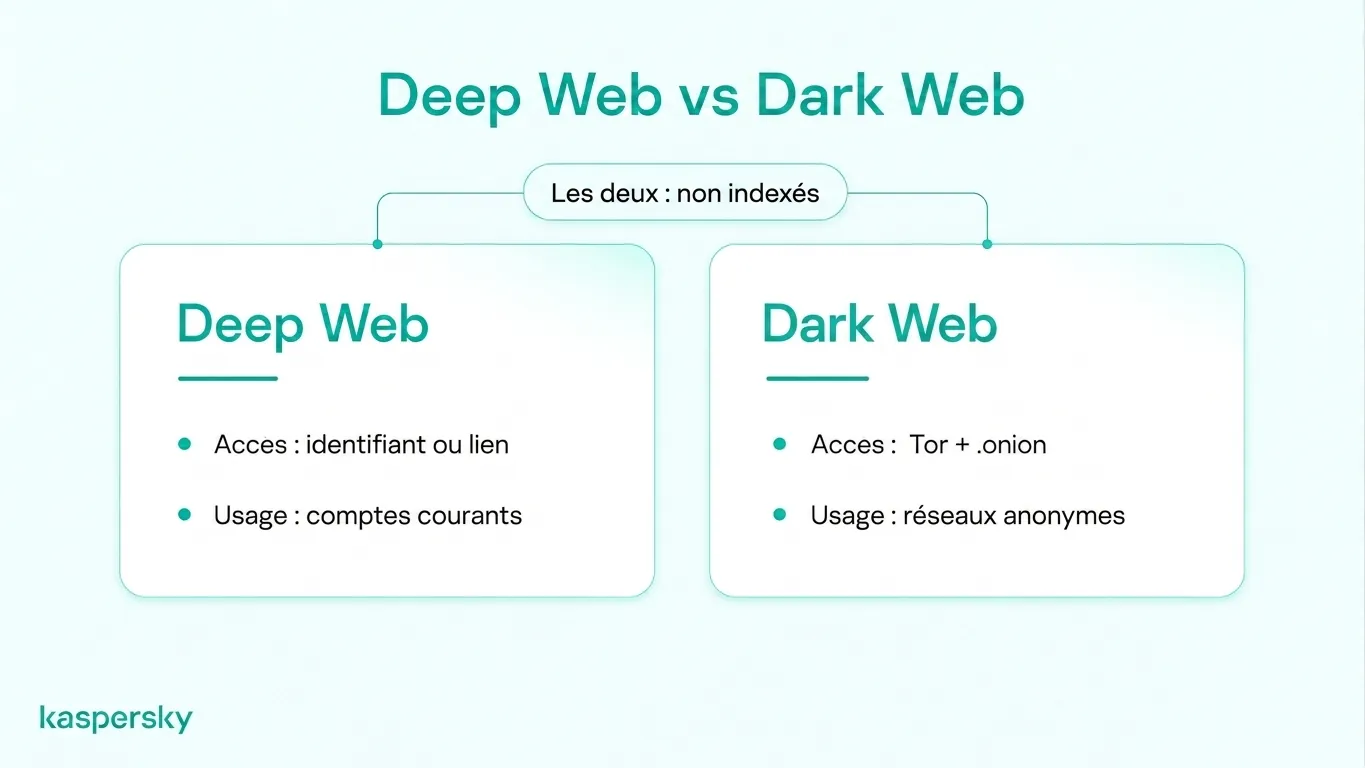
Ce tableau montre leurs différences:
|
|
Web profond |
Web clandestin |
|---|---|---|
|
Indexé par les moteurs de recherche |
Non |
Non |
|
Qui peut y accéder |
Toute personne disposant du bon lien ou des identifiants d'accès |
Les utilisateurs de réseaux d'anonymat spécialisés |
|
Contenu typique |
E‑mail, services bancaires en ligne, stockage cloud, abonnements, bases de données |
Forums anonymes et services en.onion, certains légitimes et d'autres criminels |
|
But |
Contenu privé, restreint ou non indexé |
Masquer l'identité des opérateurs et des visiteurs de sites |
|
Exigences d'accès |
Un navigateur standard plus une connexion, une URL directe ou une requête sur le site |
Tor ou un logiciel similaire plus l'adresse.onion du site |
Que pouvez‑vous trouver sur le web profond?
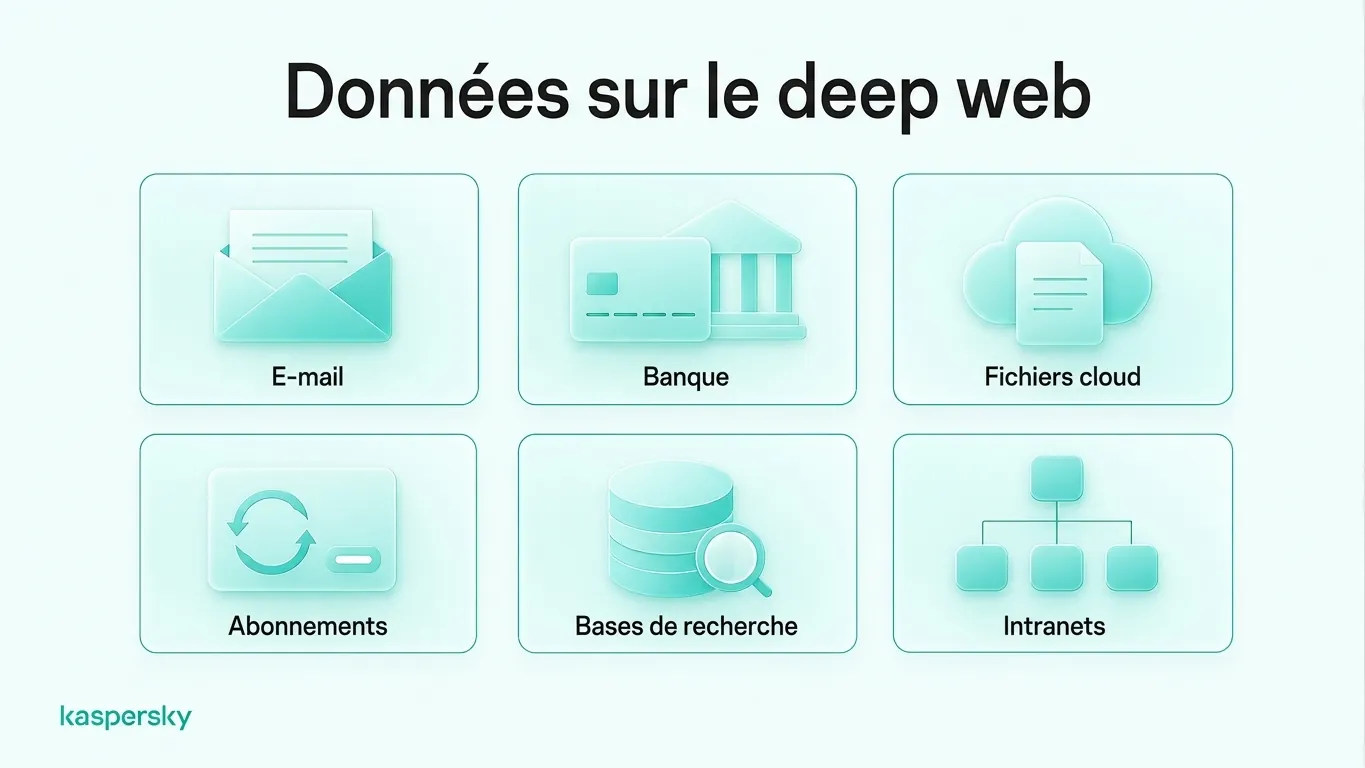
Le web profond contient une grande variété d'informations quotidiennes et spécialisées, des comptes personnels et services par abonnement aux bases de données de recherche et archives organisationnelles. Certaines ressources exigent une connexion ou une permission, tandis que d'autres ne figurent tout simplement pas dans les résultats standards.
Services personnels et usages quotidiens
Votre boîte mail, vos comptes bancaires en ligne, votre stockage cloud, votre portail patient et vos tableaux de bord de compte ne s'ouvrent qu'après connexion, si bien que les moteurs de recherche ne peuvent pas y accéder. Les publications sur les réseaux sociaux partagées uniquement avec vos amis sont limitées par des permissions, et les contenus complets des abonnements ne s'affichent qu'après paiement.
Bases de données et ressources restreintes
Universités, entreprises et administrations conservent également de grandes quantités d'informations sur le web profond. Il s'agit de bases de données de revues académiques, d'intranets d'entreprise, d'archives numériques et de documents internes.
Une partie de ces informations n'apparaît que lorsque vous la cherchez. Un portail d'archives judiciaires peut contenir des millions d'affaires, mais ne construit une page de résultats qu'après une recherche sur le portail lui‑même. Les bibliothèques universitaires en ligne fonctionnent de la même manière et demandent souvent une connexion avant d'autoriser la lecture des documents.
Comment accéder au web profond?
Vous n'avez pas besoin de logiciel spécial pour accéder au web profond. Le navigateur ou l'application que vous utilisez déjà ouvrira la plupart de ces contenus dès que vous vous connecterez ou suivrez le bon lien.
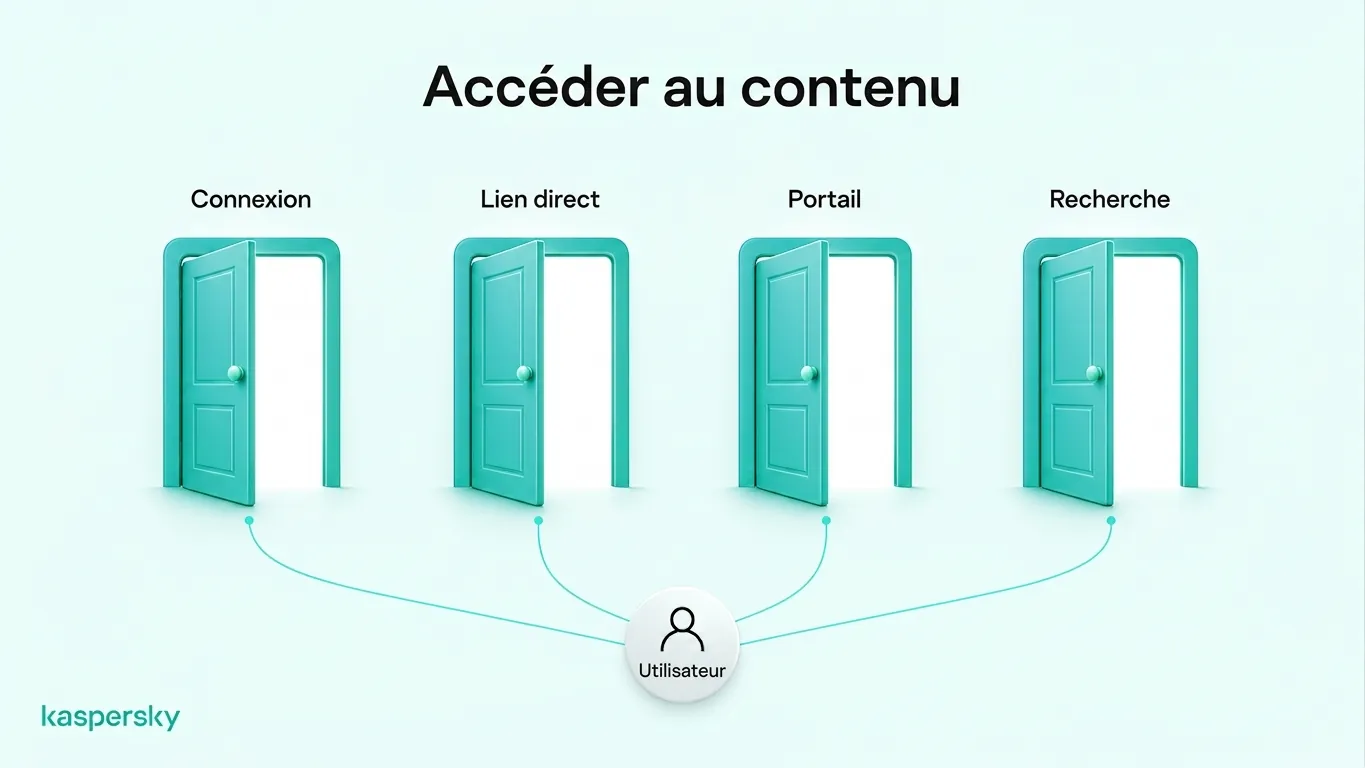
Comme il n'existe pas de site, navigateur ou réseau unique pour entrer dans le web profond, la méthode d'accès dépend de ce que vous voulez atteindre:
- Vos comptes: connectez‑vous à votre e‑mail ou à votre banque en ligne.
- Fichiers partagés: ouvrez un lien direct vers un dossier cloud privé partagé avec vous.
- Portails privés: connectez‑vous à l'intranet de votre entreprise ou à la bibliothèque universitaire.
- Bases de données consultables: utilisez le formulaire de recherche du site, comme le catalogue d'une bibliothèque ou un moteur de réservation de vols.
Tor et d'autres outils d'anonymisation ne sont pas nécessaires pour les services ordinaires du web profond. Le Tor Browser sert à accéder aux services.onion du web clandestin, qui ne sont pas disponibles via une connexion de navigateur standard.
Le web profond est‑il sûr et légal?
Le web profond n'est pas intrinsèquement illégal ni dangereux. La plupart des gens utilisent des services légitimes du web profond au quotidien, comme l'e‑mail, la banque et les comptes privés en ligne. Cependant, les mêmes risques de sécurité que sur le reste d'Internet — phishing, malwares et fuites de données — s'appliquent encore.
Le terme « web profond » décrit seulement la manière dont le contenu est trouvé et atteint, pas sa légalité ou sa fiabilité. Ce que vous y faites reste soumis au droit, qui varie selon les pays. Se connecter à sa propre boîte mail est légal, mais accéder sans autorisation au compte d'autrui ne l'est pas.
Une page n'est pas non plus forcément plus risquée parce que les moteurs l'ignorent. Votre banque, par exemple, protège souvent les pages de compte plus soigneusement que sa page d'accueil publique.
Les attaquants ciblent les comptes du web profond avec les mêmes méthodes qu'ailleurs en ligne:
- Phishing et arnaques: de fausses pages de connexion et messages imitant votre banque ou fournisseur d'e‑mail cherchent à voler votre mot de passe.
- Malware: des téléchargements ou pièces jointes malveillants peuvent installer un logiciel qui enregistre vos frappes.
- Vol d'identifiants: des mots de passe dérobés sur un service peuvent être testés sur vos autres comptes.
- Fuites de données: un service que vous utilisez peut être piraté, exposant vos données sans que vous n'ayez commis d'erreur.
Les e‑mails, relevés financiers et dossiers médicaux sont souvent stockés dans des services privés du web profond. Leur présence là‑bas ne signifie pas qu'ils ont été divulgués ou compromis. Toutefois, des violations de sécurité, des accès non autorisés ou des expositions accidentelles peuvent mettre ces informations en danger.
Comment rester en sécurité en utilisant des services du web profond?
Beaucoup d'attaques commencent par la façon dont vous vous connectez ou par ce que vous téléchargez: ces bonnes pratiques aident à sécuriser vos comptes:
- Utilisez un mot de passe fort et unique pour chaque compte, afin qu'une fuite sur un service ne compromette pas les autres. Un gestionnaire de mots de passe peut les créer et les mémoriser pour vous.
- Activez l'authentification multifacteur, qui demande une seconde vérification, par exemple un code envoyé sur votre téléphone. Un mot de passe seul volé peut alors ne pas suffire. Commencez par votre compte e‑mail, car il sert souvent à réinitialiser les autres mots de passe.
- Vérifiez l'adresse avant de vous connecter, car les pages de phishing reproduisent souvent de faux écrans de connexion. Tapez l'adresse vous‑même ou utilisez un favori plutôt que de suivre un lien reçu par e‑mail ou message.
- Maintenez votre navigateur, votre système d'exploitation et votre logiciel de sécurité à jour, les mises à jour corrigeant souvent les failles exploitées par les attaquants pour diffuser des malwares.
- Téléchargez des fichiers et ouvrez les pièces jointes seulement depuis des sources de confiance, et fournissez à chaque site uniquement les informations personnelles nécessaires à son service.
Kaspersky Premium inclut une protection antivirus et anti‑phishing, un gestionnaire de mots de passe et des alertes si vos mots de passe apparaissent dans une fuite de données.
Articles connexes:
- Qu'est‑ce que le web clandestin?
- Qu'est‑ce que le navigateur Tor?
- Comment créer un mot de passe fort
- Qu'est‑ce qu'un malware?
Produits recommandés:
FAQs
Le web profond existe‑t‑il vraiment?
Oui. Le web profond existe, mais ce n'est pas un lieu caché ni un Internet séparé. Il s'agit de contenu web que les moteurs de recherche n'indexent pas, comme des pages de compte, des contenus payants et des bases de données privées.
Quelle est la taille du web profond?
Personne ne peut mesurer précisément le web profond. Le contenu que les moteurs ne peuvent pas indexer est difficile à compter, d'où des estimations très variables. Il est probablement bien plus vaste que le web de surface, car il comprend tous les comptes privés.
Le web profond est‑il anonyme?
Pas habituellement. La plupart des services du web profond exigent une connexion, de sorte que le service sait quel compte les utilise. Le HTTPS protège vos données en transit, mais n'efface pas votre identité auprès de ce service.
Tout le monde peut‑il accéder au web profond?
Oui. Certains contenus du web profond sont accessibles via des liens directs, tandis que les comptes privés, services par abonnement et bases de données restreintes demandent des identifiants ou une autorisation. La plupart des contenus du web profond sont accessibles avec un navigateur standard.